把 OpenClaw 導入企業工作流時,團隊最先拉扯的往往不是模型要選 Claude、GPT 還是本地開源模型,而是這隻 AI Agent 到底會從哪裡拿到資料、在記憶體留多久,以及最後會把運算結果寫回哪些內部系統。
邊界沒定義清楚,Agent 很容易在執行複雜任務時,把不該外流的個資或金鑰打包送進外部 API;或是遇到網路中斷重試時,因為責任歸屬不明,導致同一筆資料被重複寫入資料庫。導入前先在白板上畫出一張簡單的資料流圖,能把討論焦點從飄渺的「AI 能做到什麼」,直接拉回扎實的「這條流程究竟可不可控」。
本篇目錄
先盤點五種資料節點,別只畫一個模糊的「AI」方塊
畫系統圖最常見的陷阱,就是在畫面正中央擺一個寫著「OpenClaw」的方形方塊,然後四周拉滿雙向箭頭。這種圖在維運與資安審核時幾乎沒有任何參考價值。
第一步不是急著連線,而是把工作流拆成五個性質完全不同的節點:
- 輸入來源: 資料是怎麼進來的?包含客服表單、顧客來信、監控系統發出的 Webhook,或是同仁在通訊軟體裡下的手動指令。
- 代理處理層: 這是 OpenClaw 的運算核心,包含系統 Prompt、條件判斷邏輯、暫時性的記憶體暫存(Context),以及任務拆解步驟。
- 工具與外部 API: 代理能呼叫的外部服務,例如讀寫 CRM、調用 Google Sheets、打搜尋引擎 API,或是操作 WordPress 後台。
- 儲存位置: 哪些內容會落地保存?包含任務執行日誌(Log)、工作階段紀錄(Session History),或是本地的 SQLite 與 Redis 快取。
- 輸出與回寫系統: 任務跑完後,最終要把成果寫去哪裡?例如發布一篇草稿、寫入 ERP 訂單庫,或是發一則 Slack 通知。
把每個節點的系統名稱、傳輸格式(如 JSON)以及「這台系統歸哪個部門管」明確標示出來,後續權限劃分才有依據。
價值在箭頭:標上「最小必要資料」與敏感標籤
資料流圖最有價值的地方在於連線的箭頭,而不是節點方塊本身。
很多自動化流程出狀況,都是因為開發人員圖方便,直接把前一手拿到的整包原始資料(Raw Payload)直接往後拋。在每條傳輸箭頭旁,至少要明確標示出四個重點:
- 必要欄位清單: 貫徹「最小必要」原則。例如客服退款流程,Agent 只需要訂單編號與退款原因,就絕對不該連同客人的身分證字號或完整卡號一起收進來。
- 敏感個資與憑證: 這段傳輸有沒有夾帶個人隱私或 API Key?進入代理前是否已經完成動態遮罩(Masking)或雜湊去識別化?
- 傳輸權限: 該連線是唯讀(Read-only)還是帶有寫入(Read-Write)權限?外部查詢工具若只需讀取,就不要開放寫入權限,防止指令注入(Prompt Injection)被竄改資料。
- 傳輸方向: 是單向推播還是雙向查詢?
把這些規則標在箭頭旁,工程師寫防護閘道或過濾腳本時,才有清晰的規格可循。
把處理、儲存與外送切成三個清楚邊界
不少導入案之所以卡在合規審核,是因為把「代理正在處理」和「系統長期儲存」混成同一件事,導致資安窗口無法得知資料究竟會被留存多久。
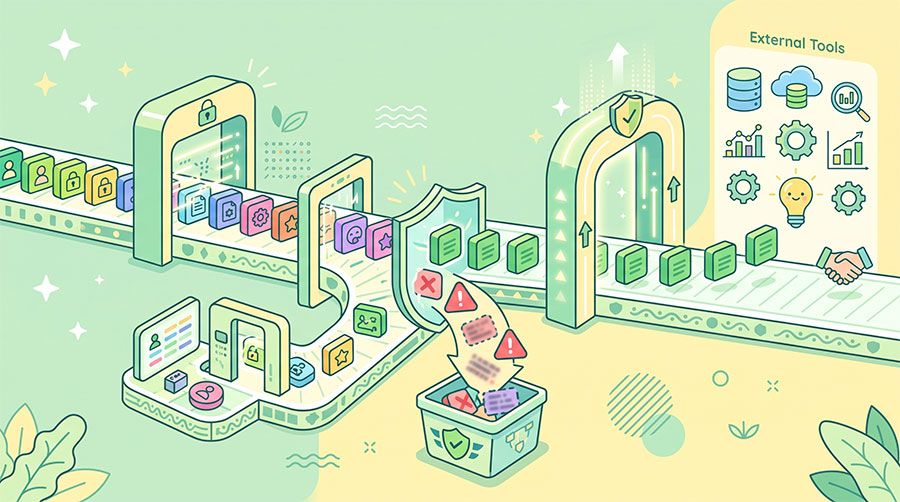
在架構設計上,務必將生命週期劃分成三個獨立邊界:
- 當次處理邊界: OpenClaw 為了理解上下文而載入記憶體的資訊。這段資料的生命週期只存在於任務當下,一旦流程結束回傳,暫存必須跟著銷毀,不能常駐。
- 長期儲存邊界: 為了除錯或事後對帳而保存的紀錄檔。這裡的資料能被誰調閱?要保存 30 天還是 90 天?過期後由誰排程清除?都需要訂出明確規則。
- 外送邊界: 資料離開企業內網或受控環境的瞬間,包含呼叫公有雲的大型語言模型供應商或第三方 SaaS。跨過外送邊界的資料,必須確認第三方合約是否承諾「不拿資料進行模型二次訓練」;沒有必要外送的欄位,在進入邊界前就該直接移除。
先定失敗時資料停在哪裡,防止重試引發災難
正常運作的路徑(Happy Path)大家都會畫,但真實的自動化維運現場,網路延遲、API 逾時與配額耗盡才是家常便飯。
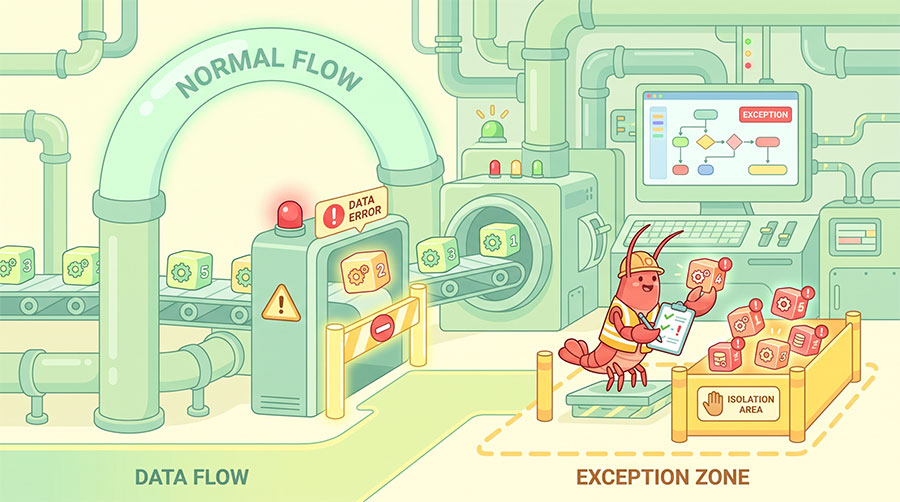
如果在架構初期沒把失敗狀態定好,自動化 Agent 一旦啟動重試機制,很可能會把錯誤成倍放大。請務必在圖上補齊以下常見異常的停泊點:
- 外部操作成功,但內部回寫逾時: 比如 Agent 已經在 WordPress 建立了文章草稿,但要寫回 Google Sheets 記錄狀態時斷線。系統重跑前必須導入「冪等性設計(Idempotency)」,先拿唯一任務 ID 去查草稿是否已存在,不能直接盲目再發一篇。
- 回寫成功但通報失敗: 內部資料庫已經扣款成功,但通報通知發送失敗。這時應該把狀態標記為「待補發通知」,而不是退回起點把整筆交易重跑一次。
- 格式錯誤或惡意輸入: 遇到非預期的髒資料或疑似注入攻擊時,代理在第一道關卡就該安全熔斷,將原始資料導向死信佇列(Dead Letter Queue),並通知人工接手排查。
用一筆去識別化的測試資料跑完整張圖
資料流圖畫完後,不要只當成簡報開完會就收進資料夾。找一筆來自實際業務情境、但已經完成「去識別化」的測試資料,沿著圖面節點實地走一遍端到端驗證。
逐站核對這幾個實務細節:
- 輸入來源送進來的 Payload,是否真的只包含必要資訊?
- 丟給外部模型的資料,敏感個資是否確實都被遮罩處理了?
- 執行中斷時,記憶體與暫存檔案是否如期釋放,沒有殘留?
- 最終寫進資料庫的資料,能不能靠一組獨立 ID 追溯出是哪一次排程產生的?
如果在測試過程中,團隊對某個節點出現「不知道這包資料歸誰管」或「不知道過期後能不能刪」的回答,就代表邊界依然存在模糊地帶。這時請立刻回頭修改圖面與過濾規則,確認責任與邊界清晰後再上線。
常見問題(FAQ)
需要,畫個簡圖即可。只要這條流程會碰到外部 API、公司內部試算表或客戶個資,就具備資料外洩或重複寫入被破壞的風險。就算只花十分鐘在白板上標出五個節點與箭頭上的資料欄位,都能替未來改版或資安排查省下大量時間。
由主導該自動化需求的「流程負責人」維護,並在變更時找系統維運與資安窗口共同確認。只要流程裡新增了一個工具、換了模型供應商,或是回寫時想多加兩個欄位,都應該回到圖上重新更新,確保任何改動都在可控範圍內。
遵循兩個原則:第一,問自己「少了這個欄位,模型還能不能完成任務?」如果不需要就能完成,該欄位就該遮罩或移除;第二,確認模型供應商的商務合約是否保證「傳輸資料不會用於模型二次訓練」。無法確認合規的,一律不送出境。
最有效的方式是在任務觸發的第一步,由來源端生成一個全域唯一的 Task ID(或 Idempotency Key)。Agent 在執行寫入動作前,必須先拿這個 ID 去目標系統查詢是否已有紀錄;若已存在就直接跳出並回報成功,避免同一筆資料被覆寫或重複建立。