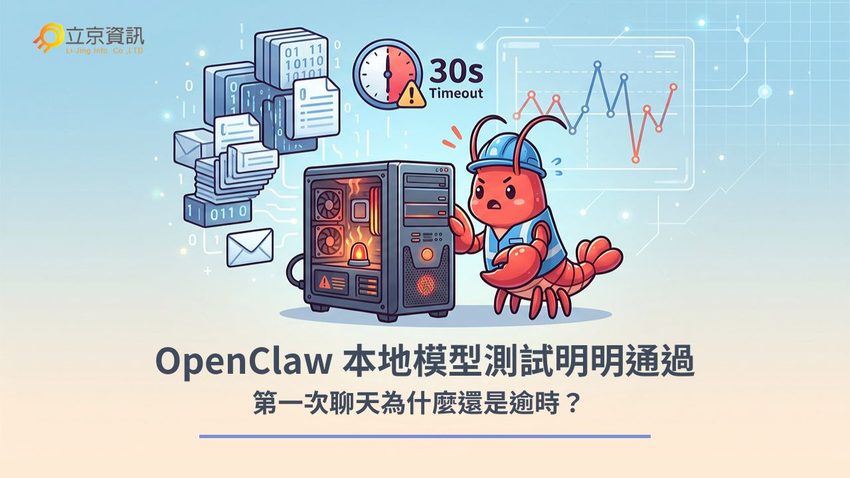
當你在本地主機部署好 AI 代理,興高采烈地跑完安裝檢查與模型推理測試,畫面顯示一切正常;結果一接上 OpenClaw 發送第一次完整對話,視窗卻轉圈轉到逾時(Timeout)……這時候先別慌,這通常不代表你的模型服務直接掛了。
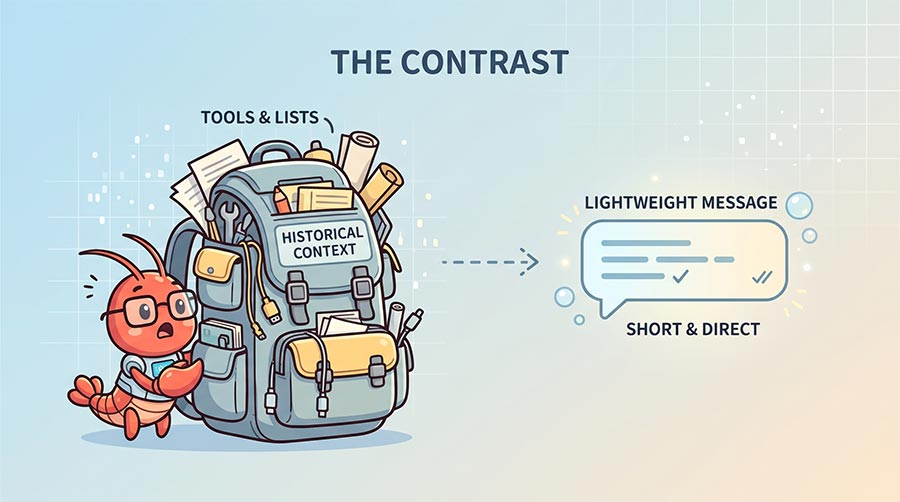
在實際維運現場,最常遇到的落差在於:平常用的驗證指令通常只送出極短的提示詞,而當真正的 AI 代理啟動時,它會把整包工具清單、工作區規則與龐大的歷史上下文全部打包送出。 特別是在資源吃緊的 CPU 主機上,這種首輪資料量的大量湧入,往往就是讓系統在「服務可用」與「一次完整對話能順利跑完」之間,暴露出明顯效能落差的主因。
本篇目錄
先把三種測試結果分開:不要被表面數據給騙了
動手抓問題之前,得先釐清你剛剛測成功的到底是哪一種:
- 第一種是安裝驗證: 只代表模型檔案健在、Ollama 或 vLLM 服務連得上、API 格式沒問題。
- 第二種是短提示詞測試: 隨手丟個簡單問候,看模型能不能吐出文字。這時候資料量極小,回應速度自然飛快。
- 第三種才是 OpenClaw 的完整對話回合: 包含了系統指令、琳瑯滿目的工具描述、工作區規則,甚至夾帶多輪工具呼叫。
前兩項過關只能證明端點還活著,完全不能保證面對第三項龐大的 Token 數量時,首字延遲(TTFT)還能壓在 OpenClaw 的逾時限制之內。排查時請把輸入大小、開始時間、首字時間與總耗時分開看,別把前兩者的正常,直接當成模型絕對沒問題的結論。
檢查點一:外掛與工具清單是不是給太多了
OpenClaw 為了讓 AI 知道自己有哪些功能可用,會在對話一開始把所有可用工具與外掛的描述塞給模型。工具裝得越多,首輪提示詞自然就越臃腫。
最直接的作法,是在不改動模型的前提下,先把這次任務用不到的工具或外掛暫時關掉,接著重啟一個全新對話視窗再測一次。如果這時候延遲明顯下降,那問題就很明確:是啟動時載入的內容太多,而不是模型本身毀損。規劃工具時別只看數量,有些複雜工具的說明文字,長度甚至比你的提問本身還要驚人。
檢查點二:試著切換精簡模式來對照
如果手邊的 OpenClaw 版本支援精簡模式(Lean Mode),不妨拿它來當作對照組做個測試。
精簡模式的好處在於能主動縮小首輪帶入的上下文,幫助我們第一時間驗證模型服務到底能不能在現有的硬體資源內,順利咬牙跑完第一個回合。不過要注意,這通常是排查時的暫時手段,設定前務必翻一下當前版本的官方文件,別拿網路上過時的參數名稱來套用。如果開了精簡模式一切正常,但切回完整模式就翻車,那就可以把兩次的耗時與工具數量記錄下來,作為後續精簡上下文或微調連線期限的依據。
檢查點三:逾時到底卡在整個流程的哪一段?
要把問題抓出來,我們得把一次請求拆成幾個部分來看:從程式發動連線、排隊等候、等待第一個 Token 吐出來、模型持續生成,到最後把工具執行結果回傳。
在純 CPU 環境下,最常見的狀況通常是等待第一個 Token 的時間(TTFT)等得特別久,或者是模型剛載入時的第一個回合吃掉太多資源。另一種可能則是模型其實算完了,但 OpenClaw 正在等外部工具回傳結果結果不小心超過時限。這時候乖乖去翻一下服務端與 OpenClaw 的日誌,對照一下時間戳記;如果是服務端根本沒收到請求,那就要回頭檢查連接埠、容器網路或代理設定;如果收到了而且持續在跑,才需要把焦點放在主機資源與逾時秒數的微調上。
調整步驟與驗證方式
維運最怕一次改十個地方,結果成功了也不知道是哪一招奏效。建議依照以下節奏來處理:先精簡不必要的工具與歷史上下文,確認當前版本對精簡模式的相容性,真的不行再考慮放寬逾時期限或是換個更輕量的模型。
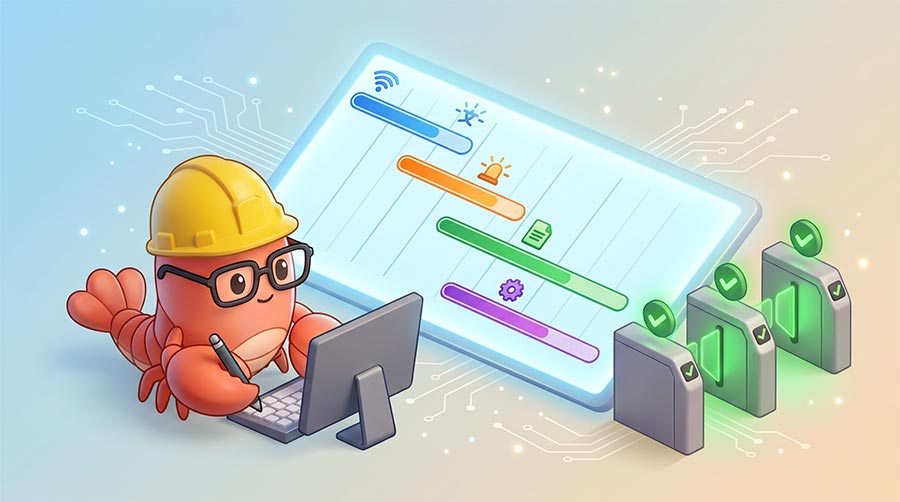
每次只動一個變數,改完後至少要通過三道驗證關卡才算過關:
- 送出一則不會觸發工具的簡單短問題。
- 送出一則會實際呼叫工具的互動問題。
- 把模型服務重啟後,測試全新對話的第一輪發問。
如果這三種情境都能在預期時間內順利跑完,雙邊日誌的時間軸也能完美對齊,這才叫真正把問題解決。若只有簡單問答能過,其餘依舊超時,建議先讓系統維持在降級運作狀態,好好檢查是不是有記憶體不足或工具重複執行的狀況。
常見問答 FAQ
不一定。這只代表基礎通訊和極輕量的推理沒卡住,並不保證當 AI 載入龐大的系統指令與工具描述後,還能在時限內吐出答案。
因為第一輪對話往往要扛下模型載入、大量工具描述注入以及上下文初始化的雙重壓力,建議透過日誌把首 Token 時間與總生成時間拆開來看。
不建議盲目調大。請先確認請求確實有送到模型端,並排除提示詞過度臃腫的問題,否則只是把記憶體不足或工具卡死的狀況給遮掩過去。