系統終端機回傳 exit code 0,不代表 Hermes 服務已經準備好接客了。最近在開發社群中經常討論到一個容易讓人誤判的情況:程式碼看似順利抓取並完成更新,但後續的相依套件 (dependency) 安裝卻默默失敗了。這會導致 Gateway 根本沒啟動,反而卡在 inactive 或是 stopped 狀態。如果維運人員只看更新腳本最後一行的成功訊息,通常要等到使用者回報或是監控警報響起,才會驚覺伺服器早就沒有回應。
這篇文章我們把焦點放在一條明確、可驗證的除錯路徑:先查 Gateway 狀態,接著嘗試恢復服務,最後落實三層健康檢查。記住,這只是初步的排查與應急處理,在找到根本原因前,別把臨時的 workaround 當成最終解法。
本篇目錄
一、把「更新成功」拆解成三個關鍵指標
第一,主程式或套件的版本確實已經替換;第二,更新後的相依套件是否完整安裝且沒有報錯;第三,Gateway 服務是不是真的在系統中穩定運行。這三件事是完全獨立的。
發生連線異常時,第一步請先截圖或匯出更新指令的完整日誌,接著利用系統服務管理指令,查詢 Gateway 究竟是 active、failed 還是 stopped。在還沒搞清楚狀況前,千萬不要急著重跑更新腳本或刪除環境,這會把最原始的錯誤日誌直接覆蓋掉。日常維運中,建議預先建立完善的 Hermes Agent 升級與版本回滾策略,並確實保存錯誤現場,才是專業排障的第一守則。
二、先查 Stopped 狀態,別急著懷疑網路或模型
如果查詢後確認服務狀態為 stopped,請優先翻找更新過程中的 dependency 日誌,確認有沒有漏裝套件,或是在編譯階段被系統強制中斷。這種層級的故障,通常跟 API 金鑰、模型供應商或外部網路沒有直接關係。簡單來說,你的伺服器根本沒在監聽通訊埠,這時候去更換語言模型只是在浪費時間。
如果狀態顯示為 failed,請保留最後幾行報錯資訊;如果是 inactive 但日誌看起來很乾淨,就要檢查一下系統變數是不是跑掉了。這跟排查 Docker 容器重啟後環境變數設定失效的邏輯非常類似,通常是因為更新前後的工作目錄或執行權限產生了落差。
三、明確且安全的恢復順序
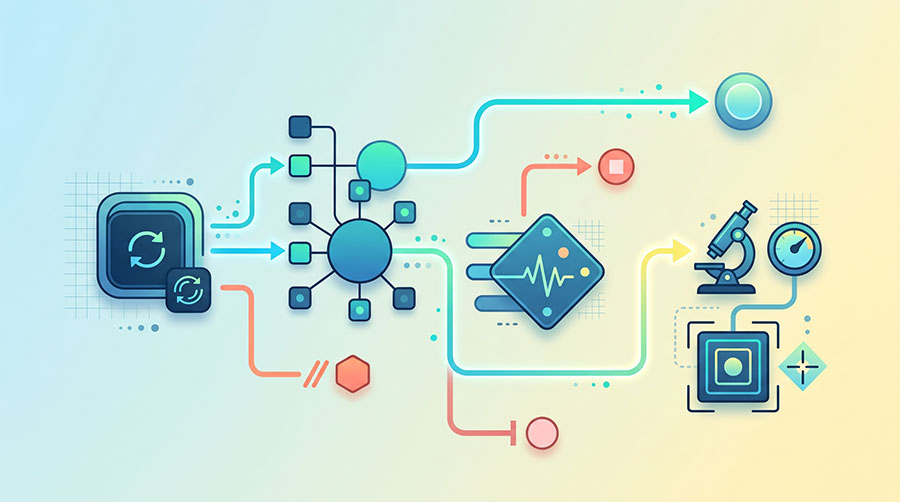
請先在原有的執行環境下,嘗試手動啟動 Gateway,然後立刻再查一次狀態。如果順利轉為 active,請馬上發送一個不涉及敏感資料的最小健康測試 (Health Check) 請求給它,確認伺服器有正常吐回資料;切記,不要一看到燈號變綠,就把自動化排程全部打開。
萬一手動重啟還是失敗,就得回頭翻找啟動報錯紀錄,必要時先將程式碼回滾 (Rollback) 到上一個已知穩定的版本,以確保線上營運不中斷。團隊若有提早導入 VPS 自動化維運與系統觀測機制,在這個節骨眼就能發揮極大作用,幫助你快速還原環境並縮短停機時間。
四、用三個訊號確認真的修好了
要宣佈警報解除,你的驗證流程至少要涵蓋三個層次:
- 版本層:核對目前伺服器執行的 Hermes 版本號是否正確。
- 服務層:觀察 Gateway 在啟動後的幾分鐘內,是否能穩定維持在 active,沒有發生反覆重啟的狀況。
- 功能層:透過 API 發送最小化請求,確認伺服器有實質回應,且內建工具都能正常初始化。
這三層都亮綠燈,這次的更新異常才能算是真正排除。如果只有版本對了但服務沒起,或是狀態 active 卻無法回應請求,系統都還是處於降級 (degraded) 甚至停機的狀態。
五、在 CI/CD 流程補上安全閘門
建議在未來的部署腳本中,加入明確的閘門機制:「更新前快照」、「執行更新」、「驗證相依套件」、「讀取 Gateway 狀態」以及「打 API 測試」。即使更新器回報 exit 0,腳本也必須主動去問系統 Gateway 的真實狀態,只要不是 active,就立刻中斷後續流程並發送警報給維運團隊。這能有效避免虛假的成功訊息掩蓋了致命錯誤。
FAQ 常見問題
不一定。建議先保留現場日誌,嘗試手動排錯與重啟;只有當服務無法在短時間內恢復,且嚴重影響到營運時,才執行版本回滾動作。
不代表。你必須進一步發送功能測試請求,確認伺服器能正常處理相依套件並給予正確回應,才算真正恢復。
非常不建議。盲目重跑很容易覆蓋掉關鍵的錯誤日誌,讓你失去找出根本原因的線索。