最危險的 AI 錯誤,往往不是畫面上出現明顯的報錯訊息,而是工具根本沒有取回有效資料,最終回答卻看起來十分完整。在 Hermes Agent GitHub issue #8993 的紀錄中,開發者發現在 v0.8.0 版本執行 web_search 或 Firecrawl 時,工具呼叫偶爾會出現不穩定的狀況:例如回傳空白、出現泛用的預設回覆,甚至是陷入重試迴圈。更麻煩的是,AI 模型可能會把沒有查到的內容,用很肯定的語氣包裝得像是已經確實查證過一樣。
雖然這只是公開問題追蹤清單上的特定個案,不代表後續每個版本或環境都會重現,但它確實提醒了所有維運人員:在建構自動化系統時,必須把「模型回答」跟「工具證據」分開驗收。
本篇目錄
先重現失敗,不要先相信摘要
在除錯或排查問題時,建議先建立一個沒有敏感資料的最小測試環境。固定好 Hermes 版本、模型、網頁後端與執行介面,接著提出一個答案絕對需要依賴即時網頁的問題,或是要求 Firecrawl 去擷取特定頁面。
測試的時候每次只改一個變因,並把 prompt、時間、版本與完整的工具回覆都記錄下來。先前提到的 issue 紀錄中,包含了畫面顯示 preparing web_search 卻回傳空白,或是嘗試呼叫無效工具的狀況。在驗證時,要把這些都當作可觀察的失敗訊號,而不是只看最後產生出來的那一段自然語言。如果你正在重新評估多代理工作流程設計,從邊界開始清楚定義每個 agent 的權限,將有助於大幅縮小這類除錯的範圍。
把一次執行拆成三份證據
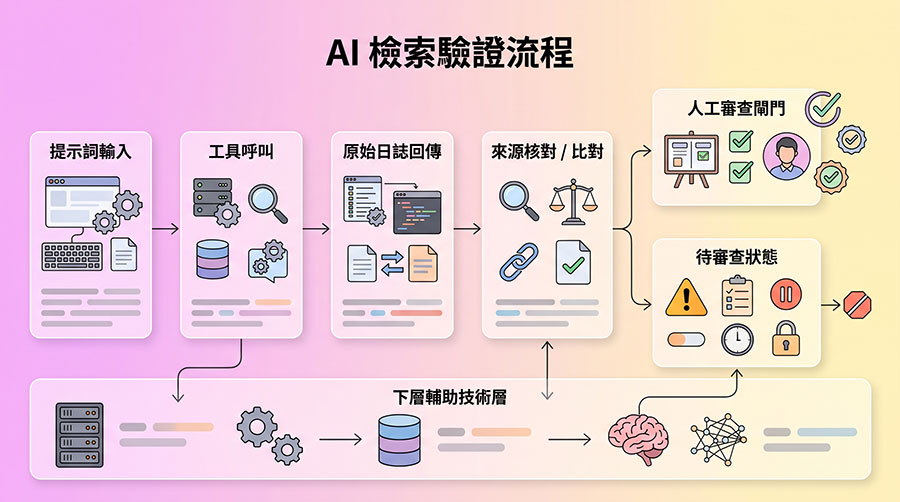
要確認 AI 真的有做事,我們可以把執行過程拆解成三個部分的證據:
- 請求證據:模型有沒有產生正確的工具名稱、參數和目標網址?
- 工具證據:工具本身有沒有回傳正確的 HTTP 狀態碼、來源網址、擷取時間或具體的錯誤訊息?只有介面上顯示 preparing 字樣是不算成功的。
- 回答證據:最終的文字內容引用了哪些來源?有沒有把工具沒抓到的細節,自行腦補成肯定句?
當這三者兜不攏時,任務狀態應該是 tool-failed 或 needs-review,絕不該是 success。
正式修復與暫時的繞道解法要分開處理
目前的 issue 在社群中仍處於待重現與討論階段。在官方釋出正式更新前,建議不要把社群上的猜測寫成已確認的 root cause。正式的修補通常需要透過 release note 或可重現的測試來拍板。
在還沒徹底修復前,可以先採用 audit workaround:先用固定的網址搭配簡短的問題來測試,強制要求工具回傳原始來源,接著透過第二個獨立的請求或直接人工開網頁來核對。這能大幅降低系統誤信資料的風險。在規劃這些驗收階段時,搭配記憶排程機制的分流與受控執行概念,能幫助你在更安全的範圍內進行驗證測試。
建立「沒有證據就暫停」的交付閘門
在打造自動化流程時,一定要將工具的輸出日誌跟最終回答存成同一筆任務紀錄。至少要保留 run id、工具名稱、輸入值、回傳狀態與時間戳記。只要發生工具回傳空值、網址不存在,或最終回答引用了日誌中根本沒出現的事實,就該立刻暫停後續的發布或寫入動作。
即使需要重試,也要把最原始的失敗紀錄留下來,不要直接用新的回覆覆蓋掉。這能避免日後回去追溯時,只剩下一段看似合理卻毫無根據的文字。如果你在規劃其他自動化專案時也常遇到卡死的狀況,不妨檢視一下目前的跳脫輪詢陷阱設計,透過調整事件驅動機制,避免系統陷入無止盡的重試與等待。
十秒驗證:問它查到什麼,不要問它是不是成功
在驗收成果時,千萬不要只問 AI「你有查到資料嗎?」,而是要明確要求它列出實際的 URL、擷取時間、原文中的特定片段,以及工具失敗時的錯誤狀態。拿到這些資訊後,親自開啟該 URL,核對那段文字是不是真的存在。
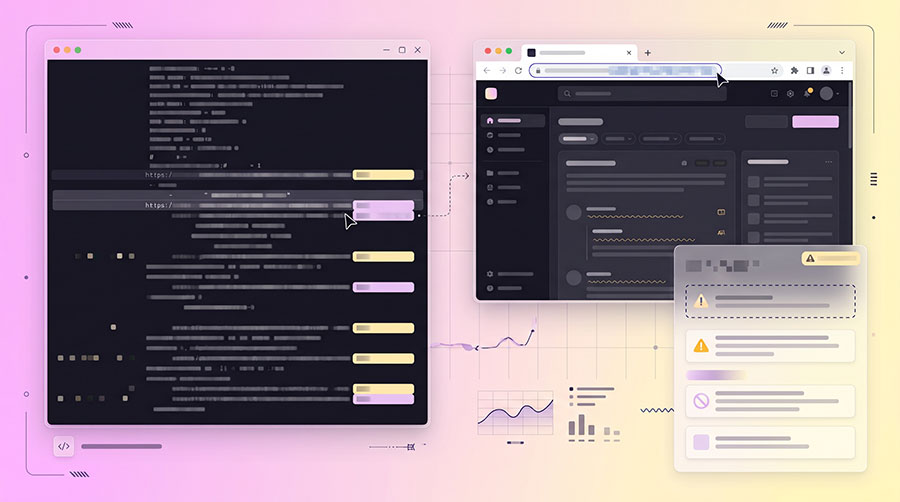
如果只有摘要而沒有來源、只有來源而工具日誌沒有回傳,或者來源內容根本不支持最終結論,就果斷把該次結果降級為未驗證草稿。這個小閘門無法完全消除模型幻覺,但絕對能有效阻止不實資訊跨過正式環境的交付線。
從 Hermes v0.23.1 的發布說明可以看出,專案仍在快速演進中。最穩妥的做法,是每次升級後重新跑一次同一組 retrieval fixture,並分別驗證工具呼叫、原始回傳日誌與最終答案。當三份證據完全吻合,才能將任務標示為完成。
常見問題 (FAQ)
不算。那只是一個流程訊號,確認有沒有查詢,還需要看工具名稱、參數、回傳狀態與實際取回的來源內容是否完整。
不代表。這是特定版本與環境下被記錄的公開個案。建議團隊還是要準備最小重現的測試,來確認自己目前使用的版本與環境是否會受到影響。
遇到這種情況,請先將任務降級為「未驗證」,改用可以保存工具回傳日誌的方式,或是直接人工開啟來源網址核對,絕對不要只依賴模型自己生成的自然語言。